Jak sieć neuronowa uczy się jeździć po budynku? Optymalizacja na przykładzie BIM Racera
Od wag i funkcji aktywacji po gradient, mutacje i test nowych map. Wyjaśniamy uczenie sieci neuronowej na przykładzie robota w Revicie.
Wyobraźmy sobie rzut kondygnacji w Revicie. Widzimy ściany, słupy i przejścia między pomieszczeniami. Wskazujemy punkt startowy oraz cel. Mały robot rusza, zbliża się do drzwi, skręca i próbuje przejechać dalej.
Na ekranie obserwujemy ruch. W tle sieć neuronowa przelicza odległości i kierunek trasy na dwie liczby: skręt oraz zadaną prędkość. Jej zachowanie zależy od wag i wyrazów wolnych. Zmiana tych parametrów może sprawić, że robot ominie słup, zatrzyma się przed przeszkodą albo wjedzie w ścianę.
Uczenie polega na poszukiwaniu takich parametrów, które prowadzą do lepszych decyzji według przyjętego kryterium. Matematycznie jest to problem optymalizacji.
W poprzednim artykule o regresji w BIM 5D dopasowywaliśmy funkcję przewidującą koszt budowy. Teraz przejdziemy do funkcji sterującej ruchem. Przykładem będzie BIM Racer: eksperymentalny dodatek do Revita 2024, rozwijany również jako laboratorium do nauki matematyki sieci neuronowych.
1. Od modelu BIM do obserwacji robota
Sieć w BIM Racerze otrzymuje niewielki wektor liczb. Zanim go przygotujemy, geometria budynku przechodzi kilka etapów:
Geometria w Revicie
        ↓
Przekrój ścian i słupów → mapa przeszkód 2D
        ↓
Symulacja robota → odległości z sensorów i prędkość
        ↓
Sieć neuronowa → skręt i zadana prędkość
        ↓
Nowe położenie robota → kolejna obserwacja
Mapa powstaje na wybranej wysokości nad poziomem. Otwory drzwiowe wynikają z geometrii ścian, a skrzydła drzwi są pomijane. W praktyce symulujemy więc otwarte przejścia.
Gdy wskazujemy cel, pojawia się dodatkowy element: algorytm A* wyznacza trasę na podstawie całej mapy. Sieć otrzymuje lokalną wskazówkę dotyczącą punktu na tej trasie i steruje ruchem robota.
Ten podział jest istotny dla interpretacji eksperymentu. Planowanie drogi wykonuje A*, natomiast uczona część odpowiada za sterowanie. Powodzenie przejazdu zależy od obu elementów oraz od jakości mapy.
W aktualnym prototypie mapa nie obejmuje m.in. instalacji MEP, mebli, schodów, szybów ani modeli podłączonych. Pojedynczy przekrój nie opisuje też przeszkód na całej wysokości robota. Jest to środowisko edukacyjne z uproszczoną geometrią.
2. Jakimi liczbami opisujemy sytuację?
Podstawowy wariant eksploracyjny ma sześć wejść: pięć odległości z sensorów i prędkość. Wariant jazdy do celu dodaje trzy informacje nawigacyjne:
| Wejście | Znaczenie | Zakres |
|---|---|---|
| Odległości od przeszkód podzielone przez zasięg sensorów | ||
| Aktualna prędkość jako część prędkości maksymalnej | ||
| Składowa kierunku punktu trasy względem robota | ||
| Druga składowa tego kierunku | ||
| Odległość do punktu trasy, ograniczona zasięgiem |
Symbol oznacza odległość do wybranego punktu trasy, a nie zawsze do końcowego celu. Program wybiera najdalszy widoczny węzeł zapisanej trasy. Dzięki temu wskazówka może prowadzić przez drzwi także wtedy, gdy trzeba chwilowo oddalić się od celu.
Dlaczego kierunek zapisujemy dwiema liczbami? Kąty bliskie i opisują prawie ten sam kierunek, choć ich wartości liczbowe znacznie się różnią. Para sinus–cosinus zachowuje ciągłość na granicy pełnego obrotu.
Skalowanie odległości także ma prostą interpretację. Przy zasięgu sensora równym 5 m przeszkoda oddalona o 2 m daje:
Sieć operuje w ten sposób na porównywalnych skalach. W zastosowaniach MEP podobnej uwagi wymagają cechy wyrażone w różnych jednostkach, np. długości, przepływy i moce. Tutaj stosujemy skalowanie według znanych granic fizycznych, a nie standaryzację obliczoną ze zbioru danych.
3. Neuron: suma, bias i aktywacja
Pojedynczy neuron wykonuje dwie operacje. Najpierw oblicza sumę ważoną i dodaje wyraz wolny, nazywany biasem:
Następnie przekazuje wynik przez funkcję aktywacji. W BIM Racerze jest nią tangens hiperboliczny:
Wejścia opisują aktualną sytuację. Wagi określają udział poszczególnych sygnałów w sumie. Bias przesuwa tę sumę niezależnie od wartości wejść.
Załóżmy, że jedno wejście wynosi , jego waga to , a pozostałe składniki sumy wraz z biasem dają . Wtedy:
Jeśli zwiększymy tylko tę wagę do , otrzymamy i aktywację około . Zmieniliśmy więc odpowiedź neuronu na tę samą obserwację. Ostateczna zmiana skrętu zależy jeszcze od dalszych połączeń.
Aktywacja nadaje sieci nieliniowość. Gdyby wszystkie warstwy wykonywały wyłącznie operacje liniowe z dodaniem biasu, ich złożenie nadal byłoby jedną funkcją liniową. Kolejne warstwy nie dawałyby takiej swobody opisu zależności.
Warto też rozdzielić dwie kwestie: możliwość reprezentowania złożonej funkcji oraz znalezienie dobrych wag. Twierdzenia o uniwersalnej aproksymacji, dotyczą pierwszej z nich przy określonych założeniach i odpowiednio dużej sieci. Nie gwarantują, że mały sterownik robota nauczy się bezbłędnej jazdy.
4. Cała sieć mieści się w dwóch równaniach
Domyślny model nawigacyjny ma strukturę 9 → 8 → 2: dziewięć wejść, osiem neuronów ukrytych i dwa wyjścia.
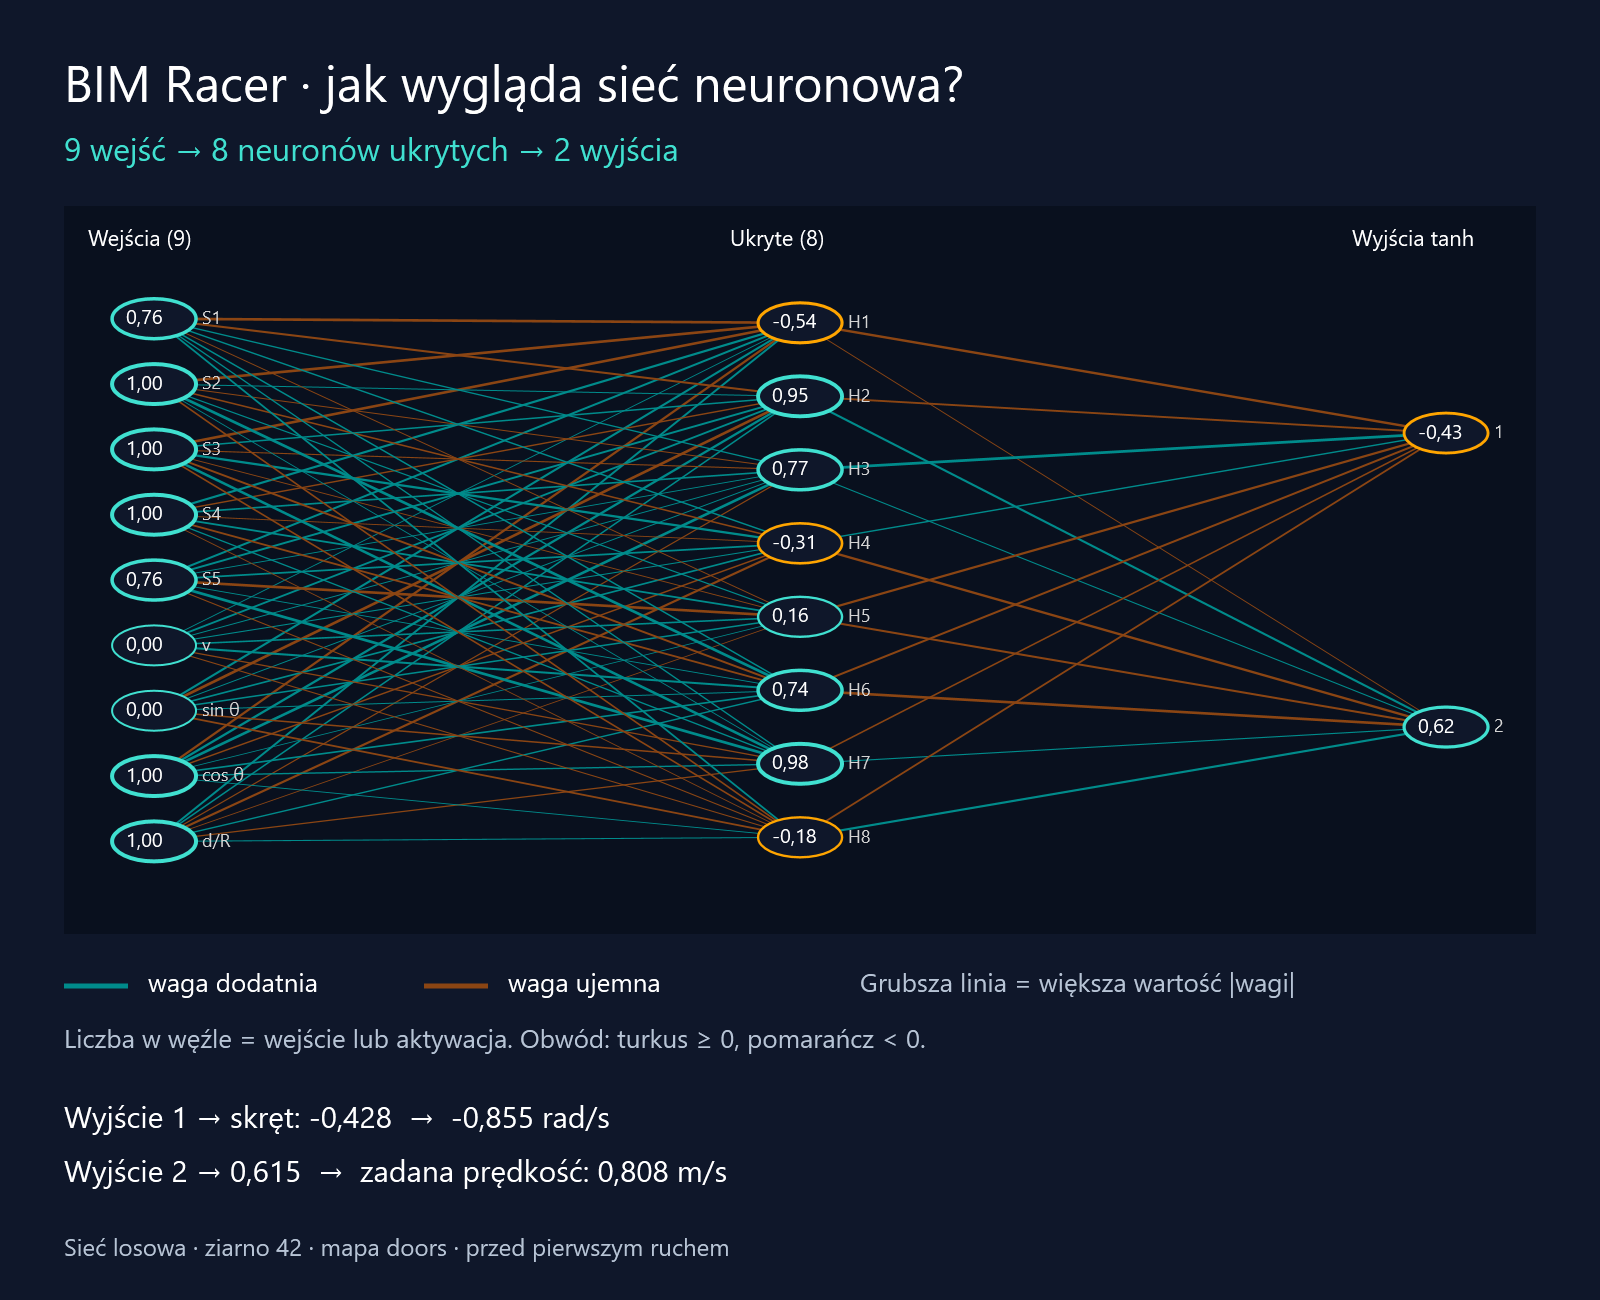
Rysunek 1. Schemat wygenerowany przez ten sam komponent, który rysuje sieć w zakładce „Mózg” w Revicie. Pokazuje niewytrenowaną sieć losową z ziarnem 42 na mapie demonstracyjnej „doors”, przed pierwszym ruchem. Wszystkie liczby pochodzą z rzeczywistych obliczeń modelu.
Schemat czytamy od lewej do prawej:
- Wejścia: pięć sensorów
S1–S5, znormalizowana prędkośćvoraz wskazówka trasy:sin θ,cos θid/R. Symbolθw panelu oznacza kąt opisany w artykule jako ;d/Rjest skróconą etykietą wartości . - Warstwa ukryta: neurony
H1–H8. Każdy otrzymuje wszystkie dziewięć wejść. Liczba w jego wnętrzu to wynik aktywacjitanh. - Wyjścia: neuron
1wyznacza skręt, a neuron2- wartość przeliczaną na zadaną prędkość. Każdy korzysta ze wszystkich ośmiu neuronów ukrytych. - Połączenia i obwody: turkusowa linia oznacza dodatnią wagę, pomarańczowobrązowa - ujemną; większa grubość odpowiada większej wartości bezwzględnej wagi. Kolor obwodu węzła pokazuje znak wejścia lub aktywacji: turkus dla wartości nieujemnych, pomarańcz dla ujemnych.
Na rysunku widać 88 połączeń: . Pozostałe 10 parametrów to biasy ośmiu neuronów ukrytych i dwóch wyjściowych - nie mają osobnych węzłów na tym schemacie. Linie przedstawiają wagi, a nie bieżące iloczyny wagi i sygnału; dlatego pozostają widoczne również przy wejściu równym zero.
W pokazanej obserwacji sieć zwraca skręt około −0,428 i drugie wyjście około 0,615. Po przeskalowaniu daje to około 0,808 m/s zadanej prędkości. Jest to propozycja niewytrenowanego modelu, a nie przykład poprawnej decyzji nawigacyjnej. W Revicie kliknięcie neuronu pozwala rozwinąć jego obliczenia; ilustracja w artykule jest statyczna.
Ten sam schemat możemy zapisać za pomocą dwóch równań:
Funkcja działa osobno na każdy element wektora. Macierz ma wymiary , a - . Każdy neuron ma własny bias, dlatego liczba parametrów wynosi:
To 98 liczb, które możemy zmieniać podczas treningu. Wariant eksploracyjny 6 → 8 → 2 ma ich 74. Liczba neuronów ukrytych jest ustawieniem, więc rozmiar sieci może być inny.
Wyjścia są przeliczane na ruch następująco:
Pierwsza liczba określa znormalizowaną prędkość kątową. Druga staje się zadaną prędkością liniową. Przykładowo oznacza jazdę z prędkością . W tym modelu ruchu nie jest to polecenie przyspieszenia.
Podczas przejazdu wybranego modelu wagi pozostają stałe. Zmieniają się obserwacje i wynikające z nich decyzje. To wnioskowanie, czyli używanie już przygotowanej funkcji. Trening jest osobnym procesem, w którym zmieniamy jej parametry.
4.1. Przykład obliczeniowy: odczytujemy wejścia z diagramu
Prześledźmy jedną decyzję dokładnie tej sieci, którą pokazuje rysunek 1. Najpierw obliczymy aktywację neuronu H1, a następnie oba wyjścia sterowania. Korzystamy z zapisanych wejść, wag i biasów niewytrenowanego modelu z ziarnem 42.
W kolejności widocznej po lewej stronie diagramu wejścia wynoszą:
Zapis oznacza transpozycję: przedstawione w jednym wierszu liczby tworzą wektor kolumnowy. Wartość dla S1 oznacza przeszkodę w odległości m przy zasięgu sensora 5 m. Wejście prędkości jest zerowe, ponieważ robot jeszcze nie ruszył. Para , wskazuje punkt trasy na wprost robota. Ostatnia jedynka oznacza, że odległość do tego punktu osiągnęła lub przekroczyła zasięg użyty do skalowania - wejście jest ograniczone do 1.
W tabelach zaokrąglamy liczby do sześciu miejsc po przecinku. Wyniki końcowe obliczono na pełnej precyzji danych. Diagram pokazuje aktywacje z dokładnością do dwóch miejsc, dlatego drobne różnice przy liczeniu na wartościach wyświetlonych są naturalne.
4.2. Obliczamy neuron H1: pomnóż, zsumuj, dodaj bias
H1 otrzymuje wszystkie dziewięć wejść. Dla każdego z nich ma osobną wagę. Pierwszy wiersz macierzy zawiera właśnie te dziewięć wag:
| Wejście | Wartość | Waga | Wkład do sumy |
|---|---|---|---|
| S1 | 0,760000 | −0,935957 | −0,711328 |
| S2 | 1,000000 | −0,941454 | −0,941454 |
| S3 | 1,000000 | −0,903868 | −0,903868 |
| S4 | 1,000000 | 0,690490 | 0,690490 |
| S5 | 0,760000 | 0,614015 | 0,466651 |
| Prędkość | 0,000000 | 0,039987 | 0,000000 |
| 0,000000 | 0,651257 | 0,000000 | |
| 1,000000 | −0,738704 | −0,738704 | |
| 1,000000 | 0,587609 | 0,587609 |
Przykładowo połączenie S1 → H1 wnosi do sumy:
Waga tego połączenia jest ujemna, więc przy dodatnim wejściu zmniejsza sumę neuronu. Dwa inne połączenia mają w tej obserwacji zerowy wkład: aktualna prędkość i sinus kąta są równe zero. Ich wagi nadal istnieją, ale mnożymy je przez zero.
Dodanie wszystkich dziewięciu iloczynów daje około −1,550603. Następnie dodajemy bias H1, równy około 0,950429:
Bias jest osobnym, dodawanym składnikiem. W tym przykładzie przesuwa sumę w stronę wartości dodatnich, ale nie wystarcza, aby zmienić jej znak.
Teraz stosujemy funkcję aktywacji:
To wartość −0,54 wewnątrz H1 na diagramie. Ujemna aktywacja jest prawidłowym wynikiem obliczeń; nie oznacza błędu ani „złego” neuronu. Staje się sygnałem wejściowym dla następnej warstwy.
4.3. Od ośmiu aktywacji do dwóch wyjść
Neurony H2–H8 wykonują tę samą procedurę, każdy z własnymi dziewięcioma wagami i własnym biasem. Otrzymujemy osiem aktywacji. Oba neurony wyjściowe korzystają z całej ósemki, lecz przypisują jej różne wagi.
W tabeli oznacza wagę połączenia Hj → wyjście 1, a - wagę Hj → wyjście 2:
| Neuron | Aktywacja | Waga do wyjścia 1 | Wkład do wyjścia 1 | Waga do wyjścia 2 | Wkład do wyjścia 2 |
|---|---|---|---|---|---|
| H1 | −0,537174 | −0,811879 | 0,436120 | −0,049622 | 0,026656 |
| H2 | 0,953364 | −0,562832 | −0,536583 | 0,655370 | 0,624806 |
| H3 | 0,769621 | 0,990869 | 0,762593 | 0,118333 | 0,091072 |
| H4 | −0,306800 | 0,307405 | −0,094312 | −0,766471 | 0,235154 |
| H5 | 0,156485 | −0,674667 | −0,105575 | −0,595505 | −0,093187 |
| H6 | 0,744350 | −0,642310 | −0,478103 | −0,893133 | −0,664804 |
| H7 | 0,983968 | −0,371303 | −0,365350 | 0,163804 | 0,161178 |
| H8 | −0,183059 | −0,487592 | 0,089258 | 0,679734 | −0,124431 |
Zwróćmy uwagę na H1 i wyjście 1. Ujemna aktywacja pomnożona przez ujemną wagę daje dodatni wkład około 0,436120. Pomarańczowe połączenie na diagramie nie musi więc zmniejszać sumy - jego wpływ zależy również od znaku przesyłanego sygnału.
Dla wyjścia skrętu suma ośmiu wkładów wynosi około −0,291952. Bias tego wyjścia to około −0,165126:
Dla wyjścia prędkości suma wkładów wynosi około 0,256443, a bias około 0,461083:
Odtworzyliśmy w ten sposób −0,43 i 0,62, widoczne w dwóch prawych węzłach diagramu.
4.4. Zamieniamy wynik na polecenie ruchu
W konfiguracji tego przykładu maksymalna prędkość kątowa wynosi 2 rad/s, a maksymalna prędkość liniowa - 1 m/s. Znormalizowany skręt przeliczamy zatem następująco:
Znak określa zwrot obrotu według układu współrzędnych symulacji. Wartość drugiego wyjścia trzeba najpierw przeskalować z zakresu od −1 do 1 na zakres od 0 do 1:
Sieć proponuje więc jednoczesny obrót i jazdę z prędkością około 0,808 m/s. To polecenie sterowania przed wykonaniem kroku. Dopiero silnik symulacji wyznaczy ruch i sprawdzi kolizję. Aktualna prędkość na wejściu nadal wynosi zero - opisuje stan przed tą decyzją.
4.5. Co zmieni zwiększenie jednej wagi o 0,1?
Na koniec wykonajmy rachunkowy odpowiednik suwaka w panelu „Mózg”. Zmieniamy wyłącznie wagę S1 → H1: z około −0,935957 na −0,835957. Wszystkie wejścia, biasy i pozostałe wagi pozostają stałe.
Zmiana sumy H1 wynosi:
Nowa suma to około −0,524174, a nowa aktywacja:
Aktywacja H1 zwiększyła się o około 0,056258. Pozostałe neurony ukryte nie zmieniły aktywacji, ponieważ nie zmieniliśmy żadnego z ich wejść ani parametrów. W warstwie wyjściowej wystarczy więc przeliczyć wpływ H1:
Po ponownym zastosowaniu tanh i przeskalowaniu prędkości otrzymujemy:
| Wielkość | Model oryginalny | Kopia po zmianie jednej wagi |
|---|---|---|
| Suma H1 | −0,600174 | −0,524174 |
| Aktywacja H1 | −0,537174 | −0,480915 |
| Znormalizowany skręt | −0,427700 | −0,464279 |
| Zadana prędkość [m/s] | 0,807687 | 0,806818 |
Wzrost aktywacji H1 spowodował bardziej ujemny skręt, ponieważ połączenie H1 → wyjście 1 ma ujemną wagę. Kierunek zmiany pojedynczego parametru nie przekłada się więc wprost na kierunek zmiany każdego wyjścia.
To obliczenie pokazuje zmianę zachowania dla jednej obserwacji. Aby ustalić, czy nowa waga poprawia jazdę, należałoby ocenić przejazdy zmodyfikowanego modelu. W panelu eksperymentalnym oglądamy jedynie kopię decyzji; sam ruch nie jest wykonywany. Związek zmiany parametrów z funkcją oceny omówimy dalej, a osobny przykład kroku gradientowego znajduje się w sekcji 7.
5. Co uznajemy za dobrą jazdę?
W regresji porównywaliśmy przewidywanie z wartością rzeczywistą. W obecnym BIM Racerze oceniamy skutki całego przejazdu za pomocą funkcji fitness. Większa wartość oznacza lepszy wynik według przyjętej punktacji.
Przy domyślnych karach fitness jazdy do celu ma postać:
Tutaj oznacza postęp na trasie w zakresie od 0 do 1, przyjmuje wartość 1 po dotarciu do celu, a - wartość 1 po kolizji. Czas przejazdu oraz czas bezruchu podajemy w sekundach. Kolizja kończy próbę.
Postęp wynika z najlepszego dotychczas zmniejszenia pozostałej długości trasy względem stanu początkowego. Wracanie po tych samych odcinkach nie pozwala wielokrotnie pobierać tej samej nagrody. Przy celu osiągniętym już na starcie składnik postępu jest zerowy.
Poniższe liczby są przykładem rachunkowym, a nie pomiarem działania modelu. Przyjmujemy brak bezruchu:
| Przebieg | Założenia | Fitness |
|---|---|---|
| Dotarcie do celu | , , , | |
| Kolizja po części trasy | , , , |
W trybie eksploracji obowiązuje inna punktacja: nagradzane są nowe pola i pomieszczenia, a karane kolizje, bezruch oraz czas bez odkrywania nowych pól. Po wskazaniu celu nagrody eksploracyjne są wyłączane. Definicja zadania zmienia definicję sukcesu.
Funkcja oceny jest częścią projektu inżynierskiego. Jeżeli nagradzalibyśmy wyłącznie przebyty dystans, jazda w kółko mogłaby okazać się korzystna. Jeśli nagroda za dotarcie byłaby nieobecna, robot mógłby poprawiać częściowy wynik bez ukończenia zadania.
Dla parametrów sieci zapisanych wspólnie jako szukamy dużego . Możemy równoważnie zdefiniować stratę i szukać jej minimum. Sama zmiana znaku nie daje jednak funkcji przydatnej do bezpośredniego różniczkowania przez całą symulację.
6. Gradient podpowiada kierunek zmiany parametrów
Jedna z metod optymalizacji jest to zstępowanie gradientowe:
Gradient zawiera pochodne straty względem parametrów. Wskazuje kierunek jej najszybszego lokalnego wzrostu w standardowej geometrii przestrzeni parametrów. Odejmując jego wielokrotność, próbujemy stratę zmniejszyć. Długość kroku ustala dodatni współczynnik uczenia .
Mały krok może oznaczać powolny postęp. Zbyt duży może pogorszyć wynik lub zdestabilizować trening. Powierzchnia straty sieci jest zwykle niewypukła: może zawierać minima lokalne, punkty siodłowe i płaskie obszary. Pojedynczy kierunek lokalnej poprawy nie jest gwarancją znalezienia najlepszego rozwiązania.
W uczeniu na dużym zbiorze przykładów gradient często szacujemy na losowo wybieranych małych partiach danych. Tak działają popularne warianty stochastycznego zstępowania gradientowego, czyli SGD. Uaktualnienie jest tańsze niż przeliczenie całego zbioru, ale kolejne oceny kierunku mogą się wahać. Mechanizmy te szerzej omawia rozdział o optymalizacji w książce Deep Learning.
Jak taki trening mógłby wyglądać dla robota? Można byłoby zebrać przykłady obserwacji i odpowiadających im decyzji dobrego sterownika, a następnie minimalizować błąd naśladowania. To możliwy kierunek rozwoju BIM Racera; aktualny trening wykorzystuje inną metodę.
7. Propagacja wsteczna: policzmy jeden krok
Propagacja wsteczna oblicza gradient z wykorzystaniem reguły łańcuchowej. Optymalizator korzysta następnie z tego gradientu, aby zmienić parametry. Są to dwa odrębne zadania. Takie rozdzielenie widać również w dokumentacji automatycznego różniczkowania PyTorch.
Weźmy własny, uproszczony przykład jednego neuronu sterującego skrętem:
Wartość oznacza pożądany skręt podany przez nauczyciela. Przyjmijmy , , i . To demonstracja matematyczna, a nie zapis treningu BIM Racera.
Z wcześniejszego obliczenia wiemy, że . Strata wynosi około . Reguła łańcuchowa daje:
Dla biasu ostatni czynnik wynosi 1, więc:
Przy , aktualizując oba parametry na podstawie tych samych początkowych wartości, otrzymujemy:
Nowe wyjście wynosi około , a strata spada do . W tym kroku zbliżyliśmy się do pożądanego skrętu.
W wielowarstwowej sieci rachunek obejmuje więcej zależności. Propagacja wsteczna przechodzi przez graf obliczeń od straty w stronę wcześniejszych warstw i wykorzystuje wspólne wyniki pośrednie. Dzięki temu można policzyć wpływ wszystkich wag bez zmieniania każdej z nich osobno i ponawiania pełnego eksperymentu.
8. Jak naprawdę trenuje BIM Racer?
Aktualna implementacja dobiera wagi algorytmem genetycznym. Taki sposób uczenia sieci nazywamy neuroewolucją. Ocena pochodzi z symulowanych przejazdów, a nowe parametry powstają przez selekcję, krzyżowanie i mutacje.
Jedna generacja przebiega następująco:
- Każda sieć z populacji steruje robotem w zadanych scenariuszach.
- Program oblicza fitness każdej sieci. Dla nawigacji jest to średnia wyników ze wszystkich scenariuszy treningowych.
- Najlepsze osobniki przechodzą do kolejnej generacji bez zmian - to elityzm.
- Rodzice pozostałych osobników są wybierani w turniejach po trzy sieci.
- Każdy parametr potomka pochodzi losowo od jednego z dwóch rodziców.
- Wybrane parametry otrzymują losową mutację. Powstaje nowa populacja do oceny.
Domyślne ustawienia obejmują populację 64 sieci, 6 zachowanych elit, prawdopodobieństwo mutacji każdego parametru 0,05 i siłę mutacji 0,2. W przypadku mutacji do parametru dodawane jest zaburzenie gaussowskie o odchyleniu standardowym 0,2. Parametry potomków są ograniczane do przedziału od −10 do 10.
Wariant nawigacyjny ocenia każdą sieć na dziewięciu scenariuszach: bieżącej mapie oraz ośmiu mapach syntetycznych. Cała populacja korzysta z tego samego zestawu, co pozwala porównywać wyniki.
Takie podejście nie wymaga obliczania pochodnej kolizji, wyboru punktu trasy czy końca epizodu. Ceną jest konieczność wykonania wielu symulacji. Sama sieć z aktywacją tanh jest różniczkowalna, lecz w aktualnym treningu nie różniczkujemy przez cały mechanizm oceny przejazdu.
| Element | Uczenie gradientowe z demonstracji | Neuroewolucja w przykładzie |
|---|---|---|
| Informacja o jakości | Błąd względem decyzji nauczyciela | Wynik przejazdu |
| Sposób zmiany wag | Aktualizacja na podstawie gradientu | Krzyżowanie i mutacje |
| Główne ustawienie wielkości zmiany | Współczynnik uczenia | Siła mutacji |
| Jednostka postępu | Aktualizacja parametrów po partii danych | Ocena i odtworzenie populacji |
| Propagacja wsteczna | Służy obliczeniu gradientu | Nie jest wykonywana |
Tabela porównuje dwa konkretne podejścia do tego projektu. Metody gradientowe mogą także uczyć z nagród, np. w algorytmach gradientu polityki; nie są ograniczone do naśladowania nauczyciela.
9. Inicjalizacja i nasycenie wpływają na zachowanie sieci
Trening zaczyna się od pewnych wag. W BIM Racerze początkowa populacja używa losowania zależnego od liczby wejść i wyjść warstwy:
Biasy są początkowo zerowe. Jest to inicjalizacja typu Glorota, znana też jako Xavier. Znaczenie skali początkowych wag opisuje praca Glorota i Bengio. Edukacyjny przycisk „Sieć losowa” korzysta w projekcie z prostszego losowania parametrów; nie należy utożsamiać go z inicjalizacją populacji treningowej.
Dlaczego skala ma znaczenie? Dla dużej dodatniej sumy wartość zbliża się do 1, a dla dużej ujemnej - do −1. Neuron jest wtedy nasycony. Dalsza zmiana sumy może dawać tylko niewielką zmianę aktywacji.
Przy uczeniu gradientowym widać to w pochodnej , która staje się mała. W naszym treningu ewolucyjnym efekt jest inny: mutacja może zmienić wagę, ale niemal nie zmienić decyzji. W obu przypadkach warto obserwować obliczenia, a nie tylko rozmiar parametrów.
Parametry i hiperparametry pełnią różne role. Parametry to wagi i biasy dobierane w treningu. Hiperparametry opisują sposób uczenia i budowę modelu, np. liczbę neuronów, populację czy siłę mutacji. Współczynniki nagród i kar określają natomiast samo kryterium jakości. Zwiększenie populacji, zwiększenie sieci i podwyższenie kary za kolizję zmieniają trzy różne części eksperymentu.
10. Dobry wynik treningowy wymaga sprawdzenia na nowych mapach
W repozytorium znajduje się zapisany eksperyment z ziarnem 42, populacją 32 sieci, 20 generacjami i 12 neuronami ukrytymi. Limit próby wynosił 1800 kroków po 1/60 s, czyli 30 sekund. Był to zatem model 9 → 12 → 2, większy od domyślnego wariantu z ośmioma neuronami.
Raport zawiera następujące wyniki:
| Model i zestaw scenariuszy | Dotarcia do celu | Kolizje |
|---|---|---|
| Sieć - trening | 9/9 | 0 |
| Sieć - sześć innych map testowych | 5/6 | 1 |
| A* + sterownik regułowy - te same mapy testowe | 6/6 | 0 |
Sieć uzyskała komplet dotarć na scenariuszach treningowych, a mimo to popełniła błąd na jednej nowej mapie. Prosty sterownik trasowy okazał się w tym małym teście skuteczniejszy. Oba rozwiązania korzystały z tras A*, więc porównujemy przede wszystkim sterowanie ruchem.
Wykres najlepszego fitnessu w panelu treningu pokazuje najlepszy wynik znaleziony do danej generacji. Przy stałych warunkach taki rekord nie maleje, ponieważ program go zachowuje. Średnia populacji może się wahać. Żadna z tych krzywych nie zastępuje oceny na nowych mapach.
Osobny test w projekcie zawiera sześć geometrii spoza treningu, ale nadal pochodzą one z podobnej rodziny syntetycznych układów. Aby ocenić przenoszenie modelu do praktyki BIM, potrzebne byłyby różne, wcześniej niewidziane budynki oraz powtórzenia z kilkoma ziarnami losowymi.
Przy doborze ustawień należy też oddzielić walidację od testu końcowego. Jeśli stale poprawiamy model po obejrzeniu wyników tych samych sześciu map, zaczynają one pełnić rolę walidacji. Do końcowej oceny trzeba wtedy przygotować kolejny, niewykorzystany zestaw.
11. Gdzie pojawia się regularyzacja?
Regularyzacja pomaga ograniczać nadmierne dopasowanie do danych treningowych. Wśród metod znajdują się m.in. kary za wielkość wag, dropout i wczesne zatrzymanie.
Kara L2 dodaje do straty składnik proporcjonalny do sumy kwadratów wag:
Współczynnik określa siłę kary względem straty zadania. Kara L1 wykorzystuje sumę i sprzyja rozwiązaniom rzadkim, w których część wag jest zerowa. Dropout losowo zeruje część aktywacji podczas treningu. Wczesne zatrzymanie kończy uczenie na podstawie przyjętego kryterium walidacyjnego, gdy dalszy trening przestaje przynosić poprawę. Techniki te opisuje także rozdział o regularyzacji w książce Deep Learning.
Normalizacja wsadowa, czyli batch normalization, normalizuje aktywacje z wykorzystaniem statystyk partii treningowej i uczonych parametrów przekształcenia. Może wpływać również na generalizację; jest jednak innym mechanizmem niż skalowanie naszych sensorów przez ich zasięg. Została opisana w pracy Ioffego i Szegedy’ego.
Aktualny BIM Racer nie implementuje dropout, batch normalization, kar L1/L2 ani automatycznego zatrzymania opartego na walidacji. Ograniczenie parametrów potomków do przedziału −10…10 jest ograniczeniem zakresu poszukiwań, a nie karą L2. Trening na wielu mapach zwiększa różnorodność doświadczeń, ale nie daje gwarancji generalizacji.
Przed dodawaniem kolejnych technik dobrym eksperymentem byłoby sprawdzenie kilku rozmiarów sieci na osobnym zestawie walidacyjnym. Większa liczba parametrów zwiększa możliwości modelu oraz przestrzeń, którą algorytm musi przeszukać.
12. Co ten eksperyment daje inżynierowi BIM i MEP?
BIM Racer pozwala zobaczyć pełny związek między reprezentacją geometrii, obserwacją, obliczeniem sieci i oceną rezultatu. Gdy robot popełnia błąd, możemy sprawdzić, jakie liczby otrzymał, jak je przekształcił i za co przyznano punkty.
Ten sposób analizy przydaje się także w innych zadaniach: przewidywaniu zużycia energii, tworzeniu modeli zastępczych obliczeń HVAC czy ocenie wariantów projektu. W każdym przypadku musimy określić wejścia, funkcję modelu, kryterium jakości i warunki sprawdzania go na nowych danych.
Warto przy tym precyzyjnie nazywać przedmiot optymalizacji. W opisanym eksperymencie optymalizujemy parametry sterownika. Geometria budynku pozostaje środowiskiem prób. Optymalizacja przebiegu kanałów wentylacyjnych wymagałaby innej reprezentacji decyzji, ograniczeń przestrzennych i kryteriów oceny. Byłoby to kolejne, odrębnie zaprojektowane zadanie.
Najbardziej pouczający moment w BIM Racerze przychodzi wtedy, gdy zatrzymujemy robota przed drzwiami, zmieniamy jedną wagę i widzimy zmianę decyzji. Możemy wtedy prześledzić drogę od liczby w macierzy do zachowania na rzucie. A później sprawdzić, czy zachowanie rzeczywiście prowadzi do celu również w innym budynku.
Źródła i podstawa opracowania
- Hala Nelson, Matematyka i sztuczna inteligencja. Kluczowe koncepcje zwiększania skuteczności i wydajności systemów, rozdział 4: „Optymalizacja w sieciach neuronowych”, Helion. Opis i spis treści wydawcy.
- Hala Nelson, Essential Math for AI, rozdział 4: „Optimization for Neural Networks”. Publiczny podgląd O’Reilly.
- Kod, dokumentacja MVP 4.3 oraz zapisany raport eksperymentu projektu BIM Racer, stan odczytany 6 października 2026 r. Parametry architektury, algorytm uczenia i wyniki przejazdów pochodzą z projektu.
- Ian Goodfellow, Yoshua Bengio, Aaron Courville, Deep Learning: optymalizacja i regularyzacja.
- Xavier Glorot, Yoshua Bengio, Understanding the difficulty of training deep feedforward neural networks, 2010.
- Sergey Ioffe, Christian Szegedy, Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift, 2015.
- PyTorch, Automatic Differentiation with torch.autograd.